01
Raumlogik
Die Platzierung von Objekten im dreidimensionalen Raum erfolgt durch eine verbesserte Koordinatenberechnung innerhalb der latenten Schichten des Modells.
Die Untersuchung der Architektur von DALL-E 3 zeigt eine signifikante Entwicklung in der Interpretation komplexer Eingabebefehle. Im Gegensatz zu früheren Iterationen erfolgt hier eine tiefgreifende semantische Dekodierung, die präzise visuelle Entsprechungen für abstrakte Konzepte generiert.
Die Platzierung von Objekten im dreidimensionalen Raum erfolgt durch eine verbesserte Koordinatenberechnung innerhalb der latenten Schichten des Modells.
DALL-E 3 demonstriert eine hohe Genauigkeit bei der Darstellung von Glyphen und Zeichenketten innerhalb generierter Rastergrafiken.
Durch die Integration von Sprachmodellen werden kurze Befehle automatisch in detaillierte technische Beschreibungen übersetzt.
Der Prozess der Prompt-Expansion in DALL-E 3 stellt einen Paradigmenwechsel in der Mensch-Maschine-Kommunikation dar. Während frühere Modelle wie DALL-E 2 oft an der Interpretation von Nuancen scheiterten, nutzt die aktuelle Version ein spezialisiertes Sprachmodell zur Anreicherung der Benutzereingaben. Dieser Vorgang wird als semantische Aufbereitung bezeichnet. Dabei wird der ursprüngliche Prompt analysiert und mit technischen Details zu Beleuchtung, Materialbeschaffenheit und Komposition ergänzt, bevor der Diffusionsprozess beginnt.
In unseren Testreihen beobachteten wir, dass die Expansion besonders bei vagen Begriffen effektiv greift. Ein einfacher Befehl wie "Industrielles Design" wird in eine komplexe Beschreibung von metallischen Oberflächen, spezifischen Lichtreflexionen und strukturellen Elementen umgewandelt. Dies reduziert die Notwendigkeit für das sogenannte "Prompt Engineering" auf Anwenderseite erheblich, da das System die technischen Lücken eigenständig füllt. Informationen zur zugrunde liegenden Hardware finden Sie in unserem Bericht über Rechenleistung und Infrastruktur.
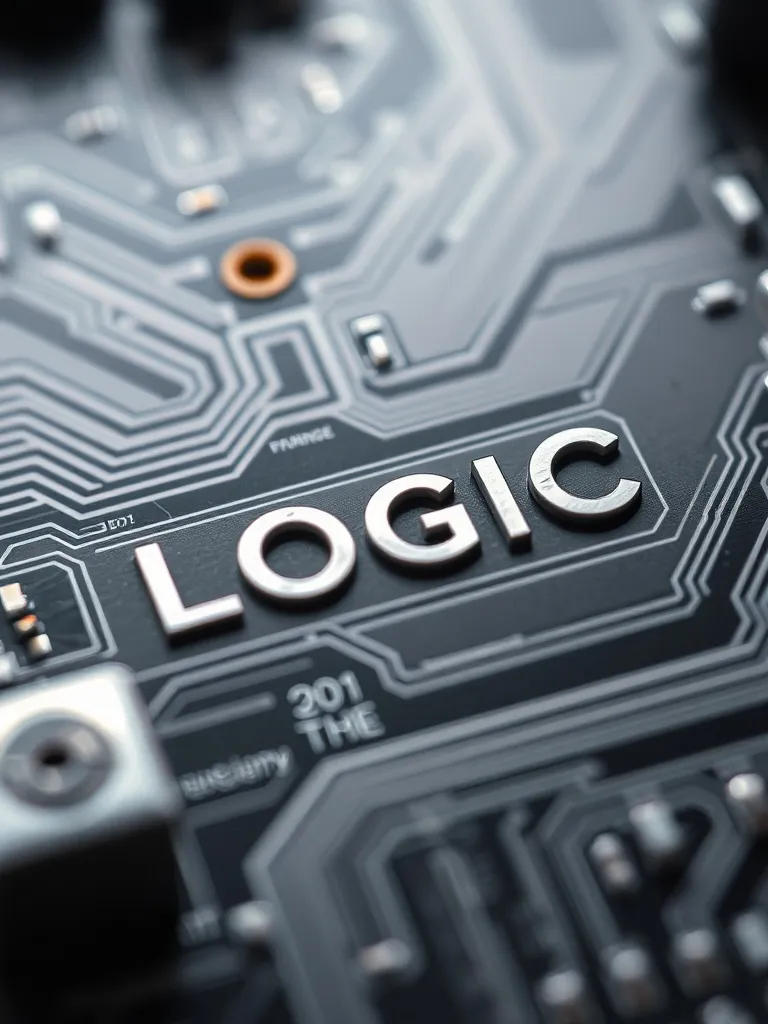
Die Fähigkeit, lesbaren Text in Bilder einzubetten, war lange Zeit eine Schwachstelle von Diffusionsmodellen. DALL-E 3 löst dieses Problem durch eine engere Kopplung von Text-Encodern und dem Bildgenerierungsprozess. Das Modell versteht nicht nur die Form von Buchstaben, sondern auch deren semantische Platzierung im Kontext des Bildes.
Die Integrationslogik beschreibt, wie DALL-E 3 verschiedene Bildelemente zu einem kohärenten Ganzen zusammenfügt. Hierbei spielt die räumliche Relation eine entscheidende Rolle. Das Modell ordnet Objekte nicht mehr zufällig an, sondern beachtet physikalische Gesetzmäßigkeiten wie Schattenwurf, Perspektive und Verdeckungen. Diese Fortschritte basieren auf der Optimierung der Funktionsweise von Diffusionsmodellen, die eine stabilere Rauschunterdrückung ermöglichen.
"Die Präzision, mit der DALL-E 3 räumliche Anweisungen wie 'hinter dem Objekt' oder 'links oben im Anschnitt' umsetzt, markiert den aktuellen Stand der Technik in der KI-Bildsynthese."
Ein weiterer Aspekt ist die Farbkonsistenz. Durch die Analyse von Millionen von Bild-Text-Paaren hat das System gelernt, wie Lichtquellen verschiedene Materialien beeinflussen. Ein metallischer Gegenstand reflektiert in der Generierung nun korrekt die Farben seiner Umgebung, was die visuelle Glaubwürdigkeit massiv erhöht. Im Vergleich zu Midjourney liegt der Fokus hier weniger auf dem künstlerischen Stil, sondern auf der semantischen Exaktheit der Umsetzung.
DALL-E 3 nutzt eine native Integration von ChatGPT zur Prompt-Optimierung und verfügt über eine deutlich höhere Kapazität zur Darstellung von Text und komplexen räumlichen Beziehungen.
Ja, durch das verbesserte Verständnis von Strukturen können einfache technische Diagramme und Flussdiagramme mit korrekter Beschriftung generiert werden.
Die Standardauflösung beträgt 1024x1024 Pixel, wobei verschiedene Seitenverhältnisse wie 16:9 oder 9:16 ohne Qualitätsverlust unterstützt werden.
Erfahren Sie mehr über die Rechenkapazitäten und die Infrastruktur, die für den Betrieb dieser Modelle erforderlich sind, oder lesen Sie unsere Richtlinien zur Datennutzung.